File:Sorting_heapsort_anim.gif · Wikimedia Commons · See Wikimedia Commons
heapsort
Sign in to saveIn computer science, heapsort is an efficient, comparison-based sorting algorithm that reorganizes an input array into a heap (a data structure where each node is greater than its children) and then repeatedly removes the largest node from that heap, placing it at the end of the array in a similar manner to Selection sort.
Key facts
- Algorithm.caption
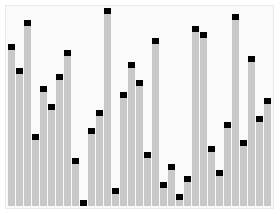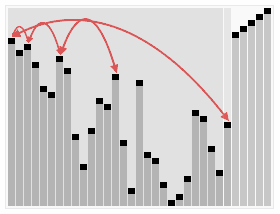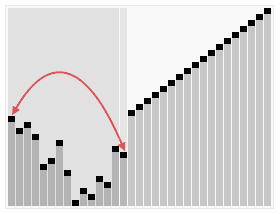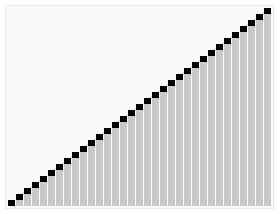
- A run of heapsort sorting an array of randomly permuted values. In the first stage of the algorithm the array elements are reordered to satisfy the heap property. Before the actual sorting takes place, the heap tree structure is shown briefly for illustration.
- Algorithm.data
- Array
- Algorithm.time
- O(n\log n)
- Algorithm.average time
- O(n\log n)
- Algorithm.best time
- O(n\log n) (distinct keys)or O(n) (equal keys)
- Algorithm.space
- O(n) total O(1) auxiliary
- Algorithm.class
- Sorting algorithm
- Algorithm.image
- File:Sorting heapsort anim.gif
via Wikipedia infobox
Wikidata facts
- Instance of
- comparison sort
- Image
- Binary heap bottomup vs topdown.svg
Show 5 more facts
- maintained by WikiProject
- WikiProject Mathematics
- derivative work
- smoothsort
- time of discovery or invention
- 1964-00-00
- Commons category
- Heap sort
Sources (2)
via Wikidata · CC0
Article · Español
El ordenamiento por montículos (heapsort en inglés) es un algoritmo de ordenamiento no recursivo, no estable, con complejidad computacional . Este algoritmo consiste en almacenar todos los elementos del vector a ordenar en un montículo (heap), y luego extraer el nodo que queda como nodo raíz del montículo (cima) en sucesivas iteraciones obteniendo el conjunto ordenado. Basa su funcionamiento en una propiedad de los montículos, por la cual, la cima contiene siempre el menor elemento (o el mayor, según se haya definido el montículo) de todos los almacenados en él. El algoritmo, después de cada extracción, recoloca en el nodo raíz o cima, la última hoja por la derecha del último nivel. Lo cual destruye la propiedad heap del árbol. Pero, a continuación realiza un proceso de "descenso" del número insertado de forma que se elige a cada movimiento el mayor de sus dos hijos, con el que se intercambia. Este intercambio, realizado sucesivamente "hunde" el nodo en el árbol restaurando la propiedad montículo del árbol y dejando paso a la siguiente extracción del nodo raíz. El algoritmo, en su implementación habitual, tiene dos fases. Primero una fase de construcción de un montículo a partir del conjunto de elementos de entrada, y después, una fase de extracción sucesiva de la cima del montículo. La implementación del almacén de datos en el heap, pese a ser conceptualmente un árbol, puede realizarse en un vector de forma fácil. Cada nodo tiene dos hijos y por tanto, un nodo situado en la posición i del vector, tendrá a sus hijos en las posiciones 2 x i, y 2 x i +1 suponiendo que el primer elemento del vector tiene un índice = 1. Es decir, la cima ocupa la posición inicial del vector y sus dos hijos la posición segunda y tercera, y así, sucesivamente. Por tanto, en la fase de ordenación, el intercambio ocurre entre el primer elemento del vector (la raíz o cima del árbol, que es el mayor elemento del mismo) y el último elemento del vector que es la hoja más a la derecha en el último nivel. El árbol pierde una hoja y por tanto reduce su tamaño en un elemento. El vector definitivo y ordenado, empieza a construirse por el final y termina por el principio.
Abstract from DBpedia / Wikipedia · CC BY-SA